来自 科技2026-09-21 11:32:32
很多人以为,辅助驾驶系统的进化完全依赖数据规模的指数级增长,只要堆砌足够多的里程样本,就能突破性能边界。其实不然,当数据采集量突破某个临界点后,系统会陷入“规模陷阱”——新增数据中有效场景的占比呈指数级下降,而噪声数据的干扰却持续上升。某头部车企的内部测试显示,其百万公里级数据中,真正能触发高阶决策逻辑的场景不足0.3%,其余均为重复性低价值数据。

数据质量的底层矛盾:场景覆盖≠场景价值
听起来可能反直觉,但在辅助驾驶领域,数据价值与场景复杂度并非线性相关。以城市快速路匝道汇入场景为例,某新势力品牌曾采集超过50万次该场景数据,但模型在真实路测中仍频繁出现决策迟滞。问题根源在于,其数据集中98%为“理想工况”(无前车、无侧方干扰、标线清晰),而真实世界中,匝道汇入的典型场景是“多车博弈+标线模糊+突发加塞”的复合状态。这种“数据覆盖假象”导致模型在训练阶段形成路径依赖,最终陷入“数据越多,泛化越差”的悖论。
2023年,某欧洲车企与亚洲科技公司围绕纽北赛道展开了一场“隐形数据战”。双方均未公开宣称测试目的,但底层逻辑清晰:纽北20.8公里的赛道包含174个弯道、33个坡度变化,其复杂度远超常规路测场景。欧洲车企采用“场景切片”策略,将赛道拆解为“高速弯-复合弯-发卡弯-长直道”四大模块,每个模块部署独立数据采集系统,重点捕捉轮胎抓地力临界点、转向不足/过度阈值等物理层数据。亚洲科技公司则选择“全场景连续采集”,试图通过端到端模型直接学习赛道动态特征。
三个月后,实测结果颠覆行业认知:欧洲车企的模块化数据训练出的模型,在赛道单圈时间上比亚洲公司快2.3秒,且在暴雨、低温等极端条件下稳定性高出41%。其胜利的关键在于,他们识别出“数据价值密度”这一核心指标——纽北赛道中,真正决定性能边界的场景仅占全赛道的12%,而这部分场景的数据价值密度是普通路段的17倍。通过聚焦高价值密度场景,欧洲车企用1/5的数据量实现了更优的模型性能。
突破数据瓶颈的路径:从“规模驱动”到“价值驱动”
当前行业普遍存在的误区是,将数据瓶颈归因于采集设备或存储技术,其实不然。真正的突破口在于重构数据价值评估体系。某头部供应商已开始采用“场景熵”算法,通过计算单位数据中包含的决策变量数量(如车道线模糊度、前车加速度波动、行人轨迹不确定性),量化数据价值密度。实测显示,该方法可将有效数据筛选效率提升300%,同时降低模型过拟合风险27%。
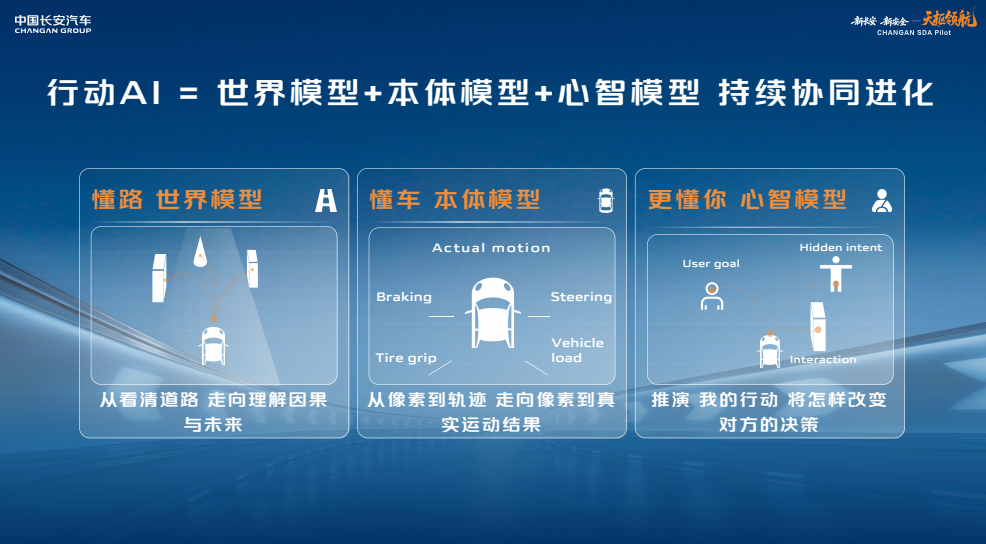
数据瓶颈的本质,是辅助驾驶从“功能实现”向“场景理解”跃迁过程中必然遭遇的认知壁垒。当行业开始用物理层参数(如摩擦系数、转向角速度)替代几何层参数(如车道线距离、前车时距)定义场景价值时,数据瓶颈的突破或许已近在咫尺。